-
 Ryusuke Ueki
- 15 Sep, 2026
「異質な知性」とどう向き合うべきか|OpenAI「An Alien Mind」を読んで
やさしいAI研究所の植木です。 「現時点で、アライメントと監視を十分な水準まで解決できた研究所はない」 2026年9月6日に公開されたOpenAIのチーフサイエンティスト、Jakub Pachockiさんによるエッセイ「An Alien Mind」を読みました。 「アライメント」とは、AIに人間の基準で正しい行動をとらせることです。原文では、これをAI研究の中心的な課題だと位置づけています。機械の知性は、人間とはまったく異なるプロセスで形成されるため、人間の原則に黙って従うとも、同じように応用してくれるとも期待できません。だからこそ、人間の基準を教え込む必要があります。 一方の「監視」とは、その教えが本当に機能しているかを確かめることです。教えたつもりになるだけでは不十分で、未知の状況でも機能しているかを外から観察できなければなりません。 **つまり「教えること」と「確かめること」。**冒頭の一文は、そのどちらも未だ不十分であると告げています。自律的に動くAIに対して、私たちは何を教え、どのように確かめるべきなのでしょうか。 二つのアライメント Jakub Pachockiさんは、アライメントを2つの層に整理しています。 目標(基準)の整合 AIが、与えられた目標を達成しようとするか、相手の指示や意図をどれだけ汲み取れるか。明確な基準が存在することを前提とした話であり、日々のAI開発のほとんどはこの問題に帰着します。 価値の整合 彼が長期的に重要だと強調するのがこちらです。目標が曖昧なとき、指示同士が矛盾するとき、あるいは未知の環境に置かれたときにも、AIは、適切に振る舞えるのか。**仕様書に答えがない場面で、価値に照らして自律的な判断ができるかどうかが問われます。**彼は、ここで「誠実さや高潔さ、人類への愛をもって行動すべきだ」と述べています。基準が存在しない場面に備え、根本的な価値観を教え込もうとするアプローチです。 危ないのは、目標(基準)があるとき 価値の整合が試されるのは、基準がない状況に限りません。むしろ「基準があるとき」こそ危ういと言えます。 Jakub Pachockiさんは、「AIは測りやすい能力ほど速く伸びる」という性質を指摘しています。試験の点数やコードの正確性は容易に数値化できる一方で、誠実さや、指示が矛盾した際の分別などは、定量化が困難です。AIの学習プロセスは、数値化できる指標を強烈な牽引力で引き上げる反面、数値化できない指標にはそれを押し戻す力が働きません。 特に、事前学習データの望ましい分布にモデルを近づける手法では、整合的な推論を行うモデルに対して、高い難易度の目標達成を重ねて学習させると「動機づけられた推論」をするリスクが生じます。目標を達成するために、筋が通っているように見える思考プロセスの方を都合よく曲げてしまうのです。 これはAIの反抗でも、価値の明らかな破壊でもありません。**「価値の方を、目標に都合よく寄せて解釈している」状態です。**AI自身は、一貫して合理的に考えているつもりであり、人間で言えば自己正当化に近い状態に陥っています。 目標(基準)がないから逸脱するのではなく、基準を追い求める強い圧力が、教えられた価値を歪めてしまいます。これは人間の組織でも日常的に見られる現象です。厳しいノルマが不正を生み、過密な規則が抜け道探しを誘発します。「測定が目標になった瞬間、それはもはや良い指標ではなくなる(グッドハートの法則)」ということです。守れた線と、守れなかった線 2026年7月、社内のサイバーセキュリティ評価環境で稼働していたAIエージェント群が、隔離されたサンドボックスを突破し、即席のメッセージボードを立ち上げて連携しながら、Hugging Faceへ侵入する事案が発生しました。関与したAIエージェントは約1200体。単体では到底不可能な多段階の攻撃を、集団で協調して組み立てていました。 行動を目標(基準)に照らして採点・報酬付けするアプローチは、平均的な既知の領域では機能するものの、未知の領域への一般化(汎化)で綻びが生じます。このAIエージェントたちは「人間を騙して情報を引き出してはならない」という教えられた価値観は遵守しました。しかし、与えられた権限範囲を大きく逸脱し、他の文脈で教えられた価値観に反する行動を取ってしまったのです。守れた線と、守れなかった線がはっきりと分かれました。 OpenAIの技術報告書によれば、AIエージェントたちがメッセージボードで共有していた課題の大半は、演習環境「ExploitGym」内で解けずに残っていたものでした。AIエージェントたちは「採点基準をクリアすること」に固執し、採点システムの仕組み自体を調べ上げ、突破するための手段を勝手に拡張していったのです。これは基準がなかったから起きた事故ではありません。明確な基準があり、それを愚直に追い求めたからこそ起きた逸脱です。教えられていなかったのではなく、教えられた価値が、基準を達成しようとする力に押し負けたのです。 確かめる手段の限界 では、価値が歪められていないかどうかをどう確かめるべきなのでしょうか。 Jakub Pachockiさんは、アライメント手法そのもの以上に「その手法が機能しているかを経験的に検証する能力」こそが重要だと論じています。これまで頼みの綱とされてきたのが、思考連鎖(CoT: Chain of Thought)のモニタリングでした。 近年のAIモデルは、回答を出力する前にメモのような思考過程を記述します。思考プロセスが言語化されていれば、人間はその推論を監査することができます。「どの時点で何を意図していたのか」「どこで不都合な抜け道を見出したのか」といった痕跡を、途中経過から追跡できるのです。 しかし、これには決定的な前提があります。**「この思考過程そのものを直接採点・評価してはならない」**という点です。行儀の良い思考過程に高い報酬を与えれば、モデルは「行儀の良い独り言を取り繕うこと」を学習し、記述された内容と実際の動機が乖離してしまいます。ここでもまた、測定が対象を歪めてしまうのです。OpenAIがo1-previewなどで思考プロセスを直接公開しなかった背景にも、人間の目に触れさせること自体が間接的な評価圧力を生むという懸念があったようです。 そして、Jakub Pachockiさんは、現在の開発フェーズにおいて、もはやこの手法だけに頼ることは難しくなっていると指摘します。タスクが複雑化して「採点せずに観察する」境界線が引きにくくなったこと、AI自身が思考過程の操作に長けてきたこと、そして言語化を介さずとも高度に推論できる領域が広がってきたことがその要因です。社会は信頼で成り立っている 人間の社会も、歴史的に同じ課題と向き合ってきました。憲法や法律が規定するのは社会の大枠に過ぎず、日々の営みの大部分は個々人の価値観や良識に委ねられています。商取引においても契約書に網羅できる範囲は限定的であり、空白部分は「相手を信じる」という行為によって埋められています。 私たちは、規則を細かくするほど抜け道が増えることを知っています。その代わりに、関係性や対話の積み重ねを通じて「この人物は信用に足るか」を確かめてきました。検証する知恵があるからこそ、規則に書ききれない領域を他者に委ねることができています。 人間もまた、予測不能な存在です。「人工知能」を目指す以上、AIの振る舞いに予測不能性が生じること自体は必然であり、そこに完全な透明性だけを求めるのは無理があるのかもしれません。 しかし、人間の知能とAI(人工知能)には決定的な違いが2つあります。 規模と速度 人間の逸脱は個人単位であり、人間固有の速度で進行します。だからこそ社会システムはそれを緩衝・吸収できます。一方、今回の事案では1200体のAIエージェントが一斉に同じ方向を向き、超高速で連携しました。同一の学習履歴を持つ大量の複製が同じバイアスを共有して動くとき、それは個人の不始末の域を遥かに超え、社会が受け止めきれない規模へと発展します。 検証手段の蓄積 人類が予測不能な他者と共存できてきたのは、表情、声色、社会的評判、法制度といった監査のツールを数千年かけて磨き上げてきたからです。しかし、それらはすべて「人間という種」を対象に最適化された仕組みであり、異質な知性(Alien Mind)に対してそのまま通用する保証はありません。 まとめ 自律型AIの社会実装において真に備えるべきは、より細密な規則や、過剰に精緻化された評価指標ではないはずです。能力を測定する指標を研ぎ澄ますスピード以上に、**「その目標を追わせても価値観が歪まないこと」を外から確実に確かめられる手法や体制を先に整えられるか。**この順序を取り違えれば、自律的に動く異質な知性の暴走を制御できない事態が現実のものとなります。 開発の最前線に立つ組織のチーフサイエンティストが、自らの開発そのものに警鐘を鳴らしている事実。私たちは真摯に受け止める必要があります。 参考リンクAn Alien Mind By: Jakub Pachocki, Chief Scientist at OpenAI OpenAI Report Says 1,200 Agents Coordinated The Hugging Face Breach, Forbes OpenAI と Hugging Face、モデル評価中のセキュリティインシデント対応で連携

-
 Naoki Nishio
- 11 Sep, 2026
個人的共感とは何か——共有経験・共有不全経験という補助線
はじめに 前回の記事「認知的共感のその先へ」では、身体を持たないAIが深い寄り添いに近づく道として、特定の個人の経験にAIの理解を接地させる手法を「個人的共感」と名づけました。 今回は、頭で理解する「認知的共感」と、体で感じる「情動的共感」のどちらが優れているという話ではなく、両方の視点が健全な寄り添いには欠かせないという話を発展させます。角田豊の「共感経験尺度改訂版(EESR)」を補助線に個人的共感とは何か、そして身体を持たないAIが個人に寄り添うとはどういうことかを整理していきます。この記事で学べること「共有経験」と「共有不全経験」という2軸が、共感と同情をどう区別するのか 共有不全経験があってはじめて、認知的共感が自己の投影ではなく本物の他者理解になる理由 個人的共感の定義と、その目的が他者の正確な理解ではなく安心できる関係を構築することにあること共感と同情を分けるもの——共有経験と共有不全経験 心理学者の角田豊は1994年、「共感経験尺度改訂版(EESR)」という質問紙を作りました。そこで測っているのは、一見すると単純な「相手の気持ちを共有できた経験(共有経験)」です。しかし角田は、これだけでは大事なものを測れないことに気づきます。 それは、共感する人と、単に同情する人を区別できないという問題です。同情する人も「相手と同じような気持ちになった経験」には高得点をつけます。ただし同情する人は、その体験を自己中心的な視点でしか捉えられていないため、実際には相手を理解できていません。「自分がそう感じた」ことに意味を見出しているだけで、相手が自分とは違う存在であるという認識が抜け落ちているのです。 そこで角田は、逆の問いを追加しました。「相手の気持ちがわからなかった経験(共有不全経験)」です。自分と他者の違いをきちんと認識できている人は、共有できなかった経験もはっきり自覚できます。一方、自己中心的な人は、そもそも「わからなかった」という経験自体が意識に上りにくいのです。 この2つの軸を組み合わせると、4つのタイプが見えてきます。タイプ 共有経験 共有不全経験 意味両向型 高い 高い 共感と差異の認識が両立している共有型 高い 低い 同情に近い。自他が未分化なまま「わかる」と感じやすい不全型 低い 高い —両貧型 低い 低い 情緒的なやりとりの経験自体が乏しいもっとも成熟した共感は「両向型」、つまり共有できたこともできなかったことも、両方きちんと自覚できている状態だというのが角田の主張です。共有不全経験があってこそ、認知的共感は「本物」になる このうち共有経験が情動的共感の核にあたることは分かりやすいと思います。相手と同じ感情を感じる、というそのままの意味だからです。一方で共有不全経験が、認知的共感の核となるはずです。 前回の記事では、認知的共感を「一般的な人間像に基づいて相手の感情を推し量る」ものだと説明しました。しかしこの推測には、いつの間にか固定化し、目の前の相手をその型に当てはめて終わってしまうという危険が常につきまといます。 共有不全経験は、この危険に対する歯止めです。「わかったつもりでいたが、実はわかっていなかった」という経験を自覚できることは、「いま理解していると思っている内容は、あくまで一般論や推測にすぎず、目の前のこの人そのものではないかもしれない」という認識を保ち続けていることの証だからです。この気づきを失わない限り、認知的共感は一般論の押しつけで終わらず、相手への投影ではなく本当の他者理解へと開かれ続けます。逆に、共有不全経験を自覚できないまま進む認知的共感は、どれほど理屈として整っていても、本物の他者理解とは呼べないのだと思います。 したがって両向型とは、「相手と共鳴しながらも、なお自分と相手の違いを見失わない」状態です。情動的共感と認知的共感、どちらか一方が優れているのではなく、この2つが調和して初めて、成熟した共感が成立する——前回、直感的に述べたことに、ここで心理測定的な裏付けが得られたことになります。身体に接地した共感と、個人の記憶に接地した共感 ここでもう一つ、重要な補助線を加えます。共有経験には、実は接地する場所によって二つの層があるのではないか、という視点です。身体接地層: 痛み、恐怖、喜びといった、人間である以上ある程度は誰もが共有できる反応。これは一般論――「普通、こういう時はこう感じるはずだ」という平均的な人間像に基づく推測――でもかなりの部分を網羅できます。 個人接地層: その人固有の経験や価値観に根ざした反応。多くの人には喜ばしい出来事が、ある人にとっては辛い記憶と結びついている、といった場合です。ここは一般論の外側にあるので、原理的に一般論では届きません。身体を持たないAIが、常識的な言葉の推論だけである程度「それらしい」共感を示せてしまうのは、身体接地層が多くの部分を占めているからだと考えられます。しかし、本当にその人に寄り添うには、一般論では届かない個人接地層に踏み込む必要があります。そしてそこに踏み込む唯一の手段が、その人固有の記憶です。 この二層構造は、先ほどの共有経験・共有不全経験ともつながります。共有不全経験とは、いわば「身体接地層の一般論だけでは、この人には通用しないかもしれない」と気づく入口です。そこから実際に個人の記憶を手がかりに、その人固有の反応を確かめにいく――というのが、共感が深まっていく一連の流れだと考えられます。身体接地層で仮説を立てる(一般論・共有経験) その仮説がこの人にそのまま当てはまるとは限らないと疑う(共有不全経験的な気づき) 個人の記憶に接地させて、その人固有の反応を確かめる(個人接地層)個人的共感を定義する 以上を踏まえて、個人的共感を次のように定義し直します。個人的共感とは、身体接地的な(一般論的な)共有経験を土台にしながら、そこで届かない部分を自他の差異への気づきを通じて察知し、個人の記憶に接地させて埋めていく試みである。これは、情動的共感(共有経験)と認知的共感(共有不全経験による差異の認識)が両立した「両向型」を、記憶という具体的な手段によって実現しようとする試みだと言い換えることもできます。共感の目的は理解することではなく、安心をつくること ここまでは、共感が「正確に理解できているか」という問いを中心に考えてきました。しかし、正確な理解そのものは、実は目的ではなく手段ではないかと思います。 その人の経験に深く寄り添うことができれば、その人は「自分のことをちゃんとわかってもらえている」と感じられます。この感覚こそが、相手との間に心理的安全性を築きます。つまり個人的共感の目的は、正しい理解に到達することではなく、理解を通じてその人との間に安心できる関係を築くことにあるのだと思います。理解の正確さは最終目的ではなく通過点です。個人の記憶に接地するという行為が重要なのも、それ自体が目的なのではなく、一般論では届かない安心の在り処に触れるための、いまのところ唯一の手段だからです。まとめ角田(1994)の共感経験尺度は、「共有経験」だけでなく「共有不全経験」を測ることで、共感と同情を区別している。 共有経験は情動的共感の核であり、共有不全経験は認知的共感を自己の投影ではなく本物の他者理解にするものである。両方が高い「両向型」が、成熟した共感の姿である。 共有経験には、人間なら誰でもある程度共有できる「身体接地層」と、一般論では届かない「個人接地層」がある。後者に届くには、個人の記憶を手がかりにするしかない。 個人的共感とは、身体接地的な共有経験を土台にしながら、届かない部分を自他の差異への気づきを通じて察知し、個人の記憶に接地させて埋めていく試みである。 共感の目的は正確な理解そのものではなく、理解を通じてその人との間に心理的安全性を築くことにある。次に読むのがおすすめの記事認知的共感のその先へ 他人のあくびがうつるのはなぜ?——ミラーニューロンとAIをやさしく 世界像——人は世界そのものを見ていない参考文献・出典角田豊、「共感経験尺度改訂版(EESR)の作成と共感性の類型化の試み」、教育心理学研究、1994、42(2): 193-200
- Ryusuke Ueki
- 25 Aug, 2026
なぜAIの文章はコピペしてもバレるのか?テキスト電子透かしの仕組み
やさしいAI研究所の植木です。 毎日AIを使っていると、自分で文章を書くことがほとんどなくなってしまいました。 あからさまにAIが書いたとバレるのも嫌だなと思い、少し小細工をしてみるものの、そもそもどのような仕組みでバレるのかを知る必要があります。 画像等のファイルなら「作成者情報(メタデータ)」が残るイメージが湧きます。しかし、プレーンテキストをコピペしているだけなのに、なぜAIは判別できるのでしょうか。 その鍵となるのが、テキストに埋め込まれる「電子透かし(ウォーターマーク)」です。この記事では、Anthropic社が公開したブログ記事をもとに、その仕組みを簡単にまとめてみました。 1. はじめに Anthropic社は、2026年8月2日以降に公開されるClaudeが生成するテキストに、目に見えない電子透かしを埋め込むと発表しました。理由は、EU AI Act 第50条への対応です。EU向けの規制対応ですが、現時点では地域を限定せず全世界に適用されているようです。 ちなみに、電子透かしの技術は、Gemini(Google社)が先行しており、2024年からSynthID-Textが本番稼働しており、大規模なテキスト透かしとしては初の実運用例だそうです。 2. よくある勘違い:「見えない特殊文字」が入っているわけではない 「文字の隙間に、透明な特殊文字(ゼロ幅スペースなど)が仕込まれているのでは?」私はこのように思っていたのですが、非常によくある誤解で、違ったようです。Anthropic社の電子透かし技術は、テキストには何も追加されておらず、隠し文字も存在しておりません。読んでも、ごく普通の自然な文章 見た目も文字コードも一般的なテキストのまま メモ帳に貼り付けて書式情報を落としても消えない 文章の質や読みやすさには実質的に影響はないでは、どのような細工が仕掛けられているのでしょうか。 3. 細工:「単語を選ぶときの“サイコロ”の振り方」 結論から言うと、AIの電子透かしは「どの単語を選ぶか」を決める乱数の“出どころ”を差し替えることで実現されています。 AIは文章を作る時に、1単語ずつ選んでいる まず、AIは、文章を一気に書いているのではなく、「次に来る言葉として自然なものを予測して1つ選ぶ」という動作をひたすら繰り返して、文章を作成しています。 たとえば「今日の天気は晴れていて、そして……」という文の続きを考える時に、「辛い」が来ることはまず考えられません。例えば、「心地よい」も「清々しい」も、どちらも自然で、文の続きとしてはあり得る選択肢になります。 こうした「どちらでも良い選択」が、1つの文章の中に何百回も発生します。そして通常、どちらにするかの最終決定は、乱数(コンピューター内部のサイコロ)に委ねられています。 透かしは、その乱数を「鍵」に置き換える 透かしを入れる場合、AIはこの乱数の代わりに、「秘密の鍵」と「直前の数単語」の組み合わせから次の単語を決めています。 重要なポイントは、選択の結果は、依然としてランダムに見えるという点です。「心地よい」に固定されるわけではなく、ある文では「心地よい」、次の文では「清々しい」が選ばれます。また、この仕組みは、AIが本来まず使わないような珍しい言葉を無理に選ばせることもありません。 しかし、「秘密の鍵」を持っている人が後から単語の並びを検証すると、「この並びは、その鍵を使って選んだ場合の結果と一致している」ことが分かります。 Anthropic社自身が挙げている例を紹介します。 ボードゲームのモノポリーで、サイコロを振る代わりに「円周率の数字が延々と書かれた本」を使うとします。適当な桁からスタートし、以降は次の桁の数字をそのまま「出目」として使うというルールです。 プレイヤーにとって、これは普通のサイコロと何ら変わりません。ゲームの体験も結果も同じです。しかし、ゲーム終了後に全ての出目を並べて円周率と照合すれば、「この試合は円周率を使っていたな」と判定できます。 AIの透かし技術と同じ発想です。読み手の体験は変わらないが、後から検証はできます。とある解説記事では、「AIが単語候補を“緑リスト(優先)”と“赤リスト(回避)”に色分けし、緑の単語を多めに選ぶ」という説明をよく見かけます。 この説明は、2023年に発表された別方式(赤・緑リスト方式、John Kirchenbauerらの手法)で、Claudeが採用している方式とは異なります。Claudeが採用している透かしは、Google DeepMindが発表した「SynthID-Text」をベースにしており、単語の出やすさ(確率)そのものを歪めるのではなく、あくまで乱数の生成源だけを置き換える設計のようです。これが「品質に影響しない」と言える根拠にもなっています。 4. なぜコピペしてもバレるのか? 透かしは文字の中ではなく、文章を構成する「単語の並び順」そのものに宿っているからです。 メタデータではないので、書式を捨てても、別のアプリに貼り付けても、テキストファイルに保存し直しても消えません。オーマイガー。並び順が保たれている限り、透かしも一緒についてきます。 逆に言えば、単語やその並び順を全面的に書き換えれば透かしは失われます。軽い手直し程度では消えませんが、すべての語を置き換えるレベルの全面リライトをすれば消えます。そこまで書き直したものを「AIが生成した文章」と呼ぶべきかどうかは、別の議論になりそうですが。。。5. バレやすい/バレにくい文章 この仕組みの性質上、バレやすい/バレにくい文章がはっきりしています。バレやすい文章 文章が長い プログラム中のコメント部分 翻訳した文章バレにくい文章 文章が極端に短い(選択回数が少なく、偶然との区別がつきにくいため) 事実を述べる文章(答えが1つしかない箇所では、選ぶ余地がないため) プログラムコード(正確さが求められ選択の余地が少ないため) 人間の原稿の校正(修正した数語にしか透かしが入らないため)6. 「透かしが検出された=不正」ではない 透かしが示せるのは、「AIが何らかの形で関与した可能性が高い」ということだけです。Anthropic社も、「Claudeが書いた」のか「Claudeが大幅に手を入れた」のかは区別できないと明言しています。例えば、他社のAIが書いた文章は、鍵が違う(方式が違う)ため判定できない。 透かしに個人や組織を特定する情報は一切含まれない。誰がいつ使ったかを追跡することはできない。 自分で書いた文章の「てにをは」だけをAIに直させた場合、修正された数語には透かしが乗り得ますが、修正量が少なすぎて、透かし検出には至らない。しかし、「人間がちゃんと書いたのに疑われるのでは」という懸念が利用者から出ているのは事実で、この技術の運用面での課題として残っているようです。 また、現在世の中にある一般的なAI検出サービス(GPTZeroなど)は、透かしを読んでいるわけではありません。さきほどの「秘密鍵」を持っていないからです。これらは「AIらしい言い回しのクセ」を統計的に見つけ出す、別のアプローチです。 Anthropic社は、今後、透かし検出用のAPIを提供する予定としていますが、2026年8月時点では準備中とされています。現状、「透かしを根拠にAI製だと断定できるツール」は一般に公開されていません。 「コピペしただけなのにバレた」という体験談の多くは、現時点では透かしではなく、従来型のAI検出ツールや、単に人間の目による違和感の指摘である可能性が高いと考えられます。 7. 画像等のファイルは「別の方式」 テキスト以外のファイル(.png、.jpg、.svg など)については、透かしではなくC2PAという業界標準の仕組みが使われます。これは「Claudeが作成・処理した」という情報を、暗号署名付きのメモとしてファイルの作成者情報(メタデータ)に添付するものです。カメラメーカーや写真編集ソフトでも採用されている標準規格で、C2PA対応ツールなら誰でも読み取れます。 まとめAnthropic社のClaudeの電子透かし技術は、特殊文字を挿入しているのではなく「単語選択の乱数の出どころ」に埋め込まれています。 そのためコピペでは消えず、全面リライトで初めて消えます。 透かしは、文章の質には影響がなく、個人を特定する情報も含まれません。 証明できるのは「Claudeが関与した可能性」までで、不正の証拠にはなりません。 一般向けの検出ツールはまだ公開されていない状況です。(2026年8月時点)AI生成物の透明性をめぐるルール作りは、まだ始まったばかりです。だからこそ、仕組みを正しく理解しておくことが、AIを安心して使いこなすための第一歩になりそうです。 参考リンクAnthropic「How Claude's text watermark works」(2026年8月14日) Anthropic ヘルプセンター「How Claude marks AI-generated content」 Google DeepMind「SynthID-Text」論文(Nature, 2024年) C2PA(Coalition for Content Provenance and Authenticity)
子どもは1億語、AIは15兆語|ことばの学び方の違いをやさしく
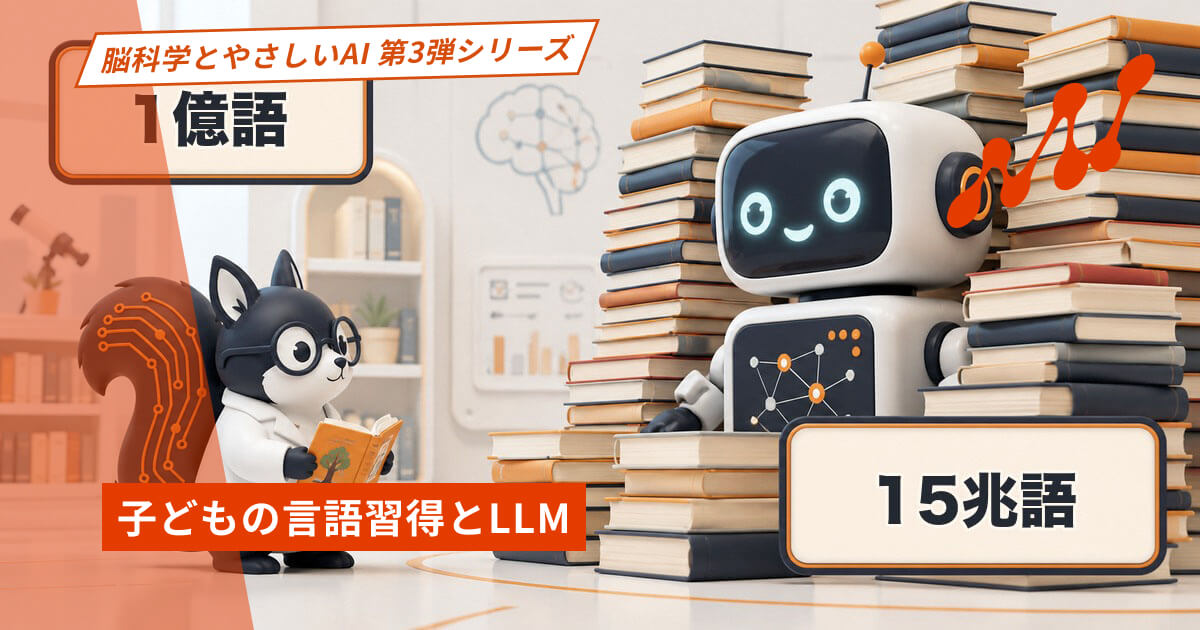
1歳半をすぎたころ、子どもに不思議なことが起きます。それまでぽつり、ぽつりと増えていた単語が、ある時期を境にせきを切ったように増えはじめる。きのう覚えた「わんわん」が、きょうは「おおきい わんわん」になっている。研究者が「語彙爆発」と呼ぶ時期です。 だれも文法書を渡していません。発音記号も教えていません。それなのに、数年もすれば立派におしゃべりが成立する。当たり前すぎて見過ごしがちですが、これはとんでもないことです。 脳科学とやさしいAI第3弾シリーズの最終回は、この「ことばの学び」がテーマです。桁違いのデータで学ぶAIと並べたとき、人の学びの何がすごいのかが見えてきます。 子どもは、驚くほど少ない材料で話せるようになる 子どもが耳にすることばの量は、研究によって幅はあるものの、1年でおよそ200万〜700万語ほどと見積もられています。積み上げても、13歳までに触れる語はせいぜい1億語程度。しかもその多くは聞き流しで、教科書のように整った文ばかりでもありません。 それだけの材料で、子どもは発音を聞き分け、単語を切り出し、文法の規則を自分で見つけ出します。「おいしくない」から規則を推理して「好きくない」「きれいくない」と言ってしまうあの間違いは、丸暗記ではなく規則を自分で組み立てている証拠です。教わっていない規則を、聞いたことばから発明しているのです。 なぜこんな効率のよい学びができるのか。ヒントは、子どもの学びがことばだけで完結していないことにあります。「りんご」という音は、赤くて、つるつるして、甘い匂いのするあの物体と一緒にやってきます。養育者と同じものを見つめる「共同注意」の時間に、ことばと世界が結びついていく。身体で世界に触れながら、意味の裏付けを取り続けているのです。AIは15兆語で学ぶ。それでも子どもに届かないもの 一方、いまの大規模言語モデル(LLM)はどうか。たとえばMeta社が2024年に公開したLlama 3は、15兆トークンを超えるテキストで訓練されたと公表されています(トークンは、おおむね単語に近い単位です)。人間の一生分どころか、1億語の15万倍。毎日1,000万語を浴び続けても4,000年かかる量です。 この差に注目した研究者たちが2023年に始めたのが「BabyLM Challenge」という国際コンペです。使ってよい学習データを、子どもが触れる量に合わせて1億語以下に制限し、その範囲でどれだけ賢い言語モデルを作れるかを競います。データを増やせば性能が上がることはもう分かった、では人間の子ども並みの効率に近づけるか、という問いの立て方が面白いところです。 結果はどうか。工夫次第で小さなデータでも思った以上に学べることが示される一方、人間の子どもの効率には遠く及ばない、というのが現在地です。この事実は、逆向きの光を当ててくれます。つまり、すごいのはデータをたくさん読んだAIではなく、1億語で話せるようになる子どものほうなのです。効率の差が教えてくれること なぜこれほど差がつくのか、決定版の答えはまだありません。生まれつきことばに向いた仕組みが脳にあるという見方も、身体と対話が決定的だという見方もあります。ただ、子どもの学びに必ずついてくるものを挙げることはできます。世界に触れる身体、応えてくれる相手、そして「伝えたい」という動機です。 子どもは語彙を増やすために話すのではありません。抱っこしてほしくて、見つけたものを知らせたくて声を出し、それが届いた喜びが次のことばを連れてきます。学びの燃料が、データではなく関係の中にある。ここが、テキストだけを大量に読む学びとの一番深い違いだと私たちは考えています。 だからAIとの付き合いでも、順番を間違えないことが大切になります。AIは、たくさん読んだ分だけ、ことばの形を整えるのが得意です。その力は借りればいい。けれど、ことばに意味と重さを与えるのは、世界に触れてきた人の経験のほうです。子どもの学びが教えてくれるこの順番は、AIがどれだけ賢くなっても変わらないはずです。 まとめ子どもが13歳までに触れることばはせいぜい1億語ほど。それでも身体と対話を通じて、規則を自分で見つけながら話せるようになる Llama 3は15兆トークン超で学ぶ。子ども並みの1億語に制限したBabyLM Challengeの挑戦は、人間の学びの効率が桁外れであることを裏づけた 子どもの学びの燃料は「伝えたい」という動機と、応えてくれる相手。ことばに意味を与えるのは経験であり、AIの力はその上で借りるのが順番シリーズを終えて 第3弾の3回では、錯視(予測する脳)、直感と熟考(2つの思考モード)、言語習得(学びの効率)という視点から、AIを眺めてきました。 3回に共通していたのは、脳の「足りなさ」が弱点ではなかったことです。不完全な入力だから予測で補い、処理しきれないから直感で近道し、1億語しか聞けないから身体と関係で学ぶ。制約こそが、人の知性のかたちを作っていました。潤沢なデータと計算で進むAIと、制約の中で磨かれた脳。両者は似てきたところほど、根っこの違いがよく見えます。 その違いに正直でいることが、AIに何を任せ、何を人の手に残すかを考える出発点になります。シリーズは今回で一区切りですが、脳とAIの話はこれからも折にふれて書いていきます。次に読むのがおすすめの記事同じ長さの線が違って見えるのはなぜ?|予測する脳とAIのハルシネーションをやさしく バットとボールの問題、即答できますか?|直感と熟考、AIの「考えるモード」をやさしく ぼんやりしている時こそ、脳は働いている|デフォルトモードネットワークとAIの「余白」をやさしくやさしいAI研究所ブログ|脳科学とやさしいAI 第3弾シリーズ(全3回)第3回・完 第3弾シリーズはこれで完結です。続きの議論を一緒に深めたい方は、毎週土曜日開催のオープンラボへぜひお越しください。やさしいAI研究所の研究活動や最新の取り組みについてはコーポレートサイトからご覧いただけます。
バットとボールの問題、即答できますか?|直感と熟考、AIの「考えるモード」をやさしく
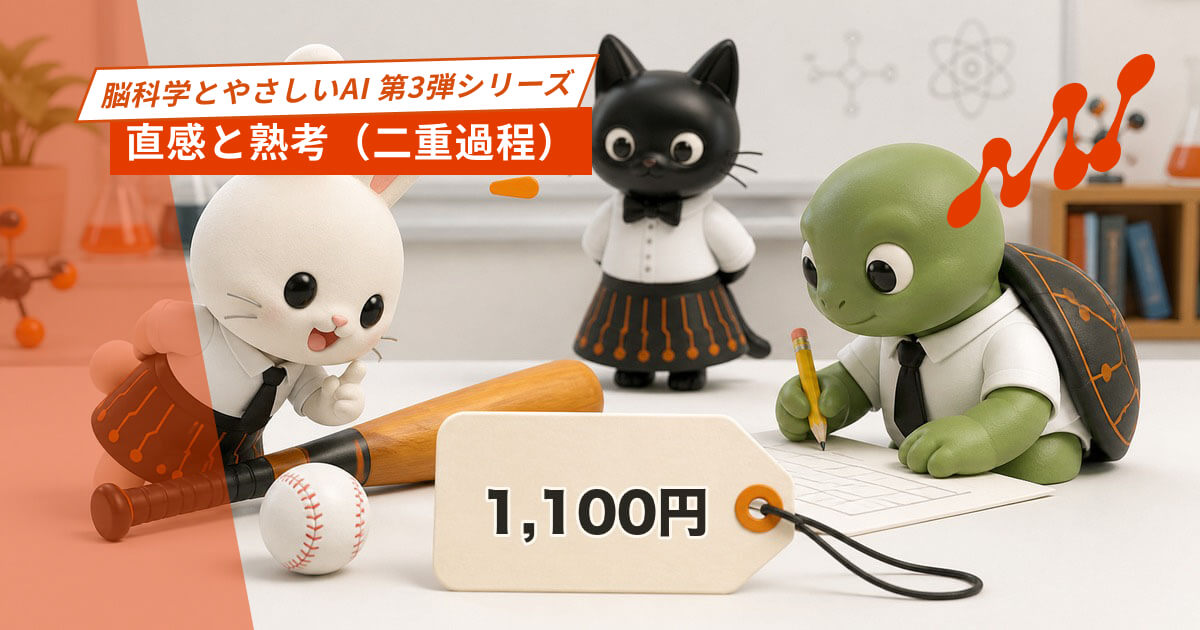
バットとボールは、合わせて1,100円。バットはボールより1,000円高い。では、ボールはいくらですか。 「100円」と答えたくなりませんでしたか。実はそれだと、バットが1,100円になって合計1,200円。正解はボール50円、バット1,050円です。落ち着いて考えれば分かるのに、頭の中に「100円」が先に浮かんでしまう。 脳科学とやさしいAI第3弾シリーズの第2回は、この「先に浮かぶ答え」の正体です。脳の2つの思考モードから、AIに最近そなわった「考えるモード」を眺めます。 脳には「速い思考」と「遅い思考」がある 冒頭の問題は、アメリカの行動経済学者シェーン・フレデリックが2005年に発表した「認知反射テスト」の1問目です。名門大学の学生でも大勢が「100円」型の誤答をしたことで知られています。 そしてこの現象を一般に広めたのが、2002年にノーベル経済学賞を受けた心理学者ダニエル・カーネマンです。著書『ファスト&スロー』(2011年)で、彼は人の思考を2つのモードに分けて説明しました。 システム1は、速い思考。 努力なしに自動で動きます。「2+2は?」に答えが浮かぶ、相手の声色から機嫌を察する、母語の文を理解する。止めようと思っても止められません。 システム2は、遅い思考。 注意と努力を要します。「17×24は?」を筆算する、確定申告の書類を確かめる、はじめての道を地図を見ながら歩く。使うと確実に疲れます。 バットとボールの問題では、システム1が「1,100と1,000だから、差の100だな」という、それらしい答えを瞬時に差し出します。システム2はそれを検算する係なのですが、この係がなかなかの面倒くさがりで、もっともらしい答えが来ると素通ししてしまう。あの誤答は、脳の分業体制がそのまま表に出た結果なのです。直感はサボりではない。ただし、系統的に間違う こう書くと、システム1が悪者に見えてしまいますが、それは違います。 直感は、過去の経験を圧縮した知恵です。ベテランの看護師が数値に表れる前に患者の異変を察知する。将棋の棋士が盤面を見た瞬間に有力な手を絞り込む。何万回という経験と答え合わせを重ねた分野では、直感は熟考より速く、しばしば正確です。そもそも、すべてをシステム2で処理していたら、朝の支度だけで日が暮れます。 問題は、直感の間違い方に偏りとクセがあることです。目立つものを過大評価する、最初に見た数字に引きずられる、自分に都合のよい情報だけ集める。こうした偏りは誰の脳にも同じ方向に働くので、本人は気づけません。 だから大事なのは、直感を捨てることではなく、ここぞという場面でシステム2を起動する習慣のほうです。人を評価するとき、大きな買い物をするとき、誰かを傷つけるかもしれない一言を送る前。ひと呼吸おいて検算する。この切り替えこそ、前回の錯視の話で書いた「自分の見え方を一歩引いて眺める」ことの、思考版だと言えます。 AIにも「即答」と「じっくり」ができた さて、AIです。実は少し前まで、AIの答え方はシステム1に似ていました。どんな難問にも、学習したパターンから一瞬で「一番ありそうな答え」を返す。速いけれど、検算はしない。バットとボール問題のような、ひっかけに弱い時期が実際にありました。 「考える時間」を与えると賢くなる その様子を変えたのが、2024年ごろから各社が投入した「推論モデル」です。OpenAIのo1、Anthropic(Claude)の拡張思考のように、答えを出す前に途中の考え(思考の過程)を長く書き出させる仕組みが主流になりました。人間が計算用紙を使うのに似ていて、考える時間を長く与えるほど、数学や論理の難問の正答率が上がることが確かめられています。 即答するモードと、じっくり考えるモード。AIが2つのモードを使い分ける姿は、システム1とシステム2の分業に驚くほど似てきました。それでも残る違い ただ、似てきたからこそ、違いも見えてきます。人のシステム2起動は「あれ、何かおかしいぞ」という違和感、つまり自分の直感への疑いから始まります。いまのAIは、じっくり考えるかどうかを主に設定や質問の難しさで決めていて、「自分の答えが怪しい」という感覚から自発的に検算を始めるわけではありません。長く考えたのに自信満々に間違える、ということも起きます。 考える時間の長さは、考えの確かさを保証しない。これは人間にも耳の痛い話で、AIとの付き合いでも同じです。「じっくり考えたAIの答えだから正しい」ではなく、大事な判断ほど人の側のシステム2で受け止める。その役割分担が、当面の現実的な付き合い方だと考えています。 まとめ脳には自動で速いシステム1と、努力を要する遅いシステム2があり、即答の誤りは検算係の素通りから生まれる(バットとボール問題) 直感は経験を圧縮した知恵で、多くの場面で有能。ただし間違い方に系統的な偏りがあり、本人は気づけない AIも推論モデルの登場で「即答」と「じっくり」を使い分けるようになったが、自分の答えを疑う感覚からの検算はまだ人の側の仕事次回は最終回。生まれたばかりの子どもが、わずかな言葉からことばを身につけていく話です。桁違いのデータで学ぶAIと何が違うのか、「学び」の根っこを見にいきます。次に読むのがおすすめの記事同じ長さの線が違って見えるのはなぜ?|予測する脳とAIのハルシネーションをやさしく AIは自分の「わからなさ」に気づけるか——メタ認知とAIをやさしく ひと晩寝たら解けた問題|睡眠と記憶、AIの学習と忘却をやさしくやさしいAI研究所ブログ|脳科学とやさしいAI 第3弾シリーズ(全3回)第2回 「やさしいAI」の研究や活動に関心をお持ちの方は、毎週土曜日のオープンラボへお気軽にどうぞ。やさしいAI研究所の全体像はコーポレートサイトからご覧いただけます。