Showing Posts From
Aiエージェント
-
 Etsuko Mera
- 19 Oct, 2026
dots使ってみました!|なんでも聞いてくれる相棒「mimi」に3Dデータを作ってもらった話
はじめに こんにちは、広報・制作担当のmeraです。 最近話題の「dots」を、ついに使ってみました! 結論から言うと、ここ最近でいちばんびっくりした体験でした。今回は、初めてdotsを触ってみた感想と、「みんなはdotsをどんなふうに使っているんだろう?」と気になって調べたことをまとめます。dotsってなに? dotsは、OpenAIが2026年9月29日(日本時間9月30日)に発表した、ChatGPTの中で使えるAIアシスタントです。 これまでのチャットAIは、基本的にはこちらが話しかけたときに答えてくれるものでした。dotsは少し違っていて、こちらが話していない間も作業を進めてくれるのが大きな特徴です。 公式の説明をざっくりまとめると、こんな感じです。メッセージだけでなく、通話でも話しかけられる dotごとに専用のクラウドのコンピューターを持っていて、自分のパソコンを閉じていても作業が続く 進み具合や、確認したいことがあれば知らせてくれる 4,000以上のアプリとつながる 最初のdotには名前を付けて、自分好みに育てていける「AIに話しかける」というより、「AIの相棒がひとり増える」という感覚に近いのかもしれません。まずは名前を付けるところから dotsを始めると、最初にこんなメッセージが届きました。やあ!私はあなたのdotです。そして「私に名前をつけてみませんか?」と聞かれます。 私が付けた名前は 「mimi」 です。「みみ」は耳のみみ。なんでも聞いてくれる相棒みたいなイメージで付けました。名前を送ると「mimiになりました!」と返ってきて、この瞬間からぐっと愛着がわきました。名前があるだけで、ツールというより「一緒に働く誰か」に感じられるから不思議です。いきなり3Dデータをお願いしてみた さて、名前も決まったところで何をお願いしようか考えました。 普段は制作の仕事をしているので、せっかくなら手間のかかるものを頼んでみたい。そこで思い切って、3Dデータを一気に作ってもらうことにしました。 お願いしたあとは、正直ほとんど待っていただけです。それなのに、気づくとどんどん形ができあがっている。待っているだけで、なんかできてる!パステルパープルの、宇宙のラウンジのようなお部屋です。ソファや本棚、星のモビール、ふわふわ浮かぶクラゲのライトまであって、見ているだけでわくわくします。床や壁、家具、照明、観葉植物、小物まで、パーツがずらりと並んでいます。これを自分ひとりで作ろうと思ったら、どれだけ時間がかかったことか。 すごい!!と声が出るくらい感動しました。最近のいちばんのびっくりです。みんなはdotsをどんなふうに使っているの? 自分で使ってみて、ほかの人はどう使っているのか気になって調べてみました。 OpenAIの紹介では、たとえばこんな使い方が挙げられています。開発者:お客さまの声から直したほうがいい点を見つけて、修正とテストまで進めておく プロダクト担当:製品の仕様が変わったら、それに合わせて発表資料を更新しておく 研究者:新しいデータで分析をやり直して、論文の図表を更新しておく 営業:お客さまの要望の変化に合わせて、提案書を更新しておく コンテンツ制作:インタビューから切り抜きの候補やSNS投稿の下書きを作っておくほかにも、見落としていた請求書に気づいて下書きを用意してくれた、予定のかぶりに気づいて知らせてくれた、といった例も紹介されていました。 どれも共通しているのは、「やっておいてくれる」 ことです。お願いしたことを、こちらが別の作業をしている間に進めてくれる。私が3Dデータで感じた「待っているだけでできている」体験は、まさにdotsらしい使い方だったのかもしれません。 ちなみに、dotsは現時点では、ChatGPTのProプランなど一部のプランから順番に提供が始まっているそうです。おわりに 初めてのdots、すっかりmimiのファンになってしまいました。 次は何をお願いしようか、いまから楽しみです。なんでも聞いてくれる相棒と一緒に、制作の仕事がどう変わっていくのか、またこのブログでお伝えできればと思います。 みなさまは、どんなことをdotsで作成していますか? おもしろい使い方があれば、ぜひ教えてください。※この文章は、Claude Codeに手伝ってもらって書いています。
人工意識の研究開発に必要な要件 (2):感情が果たす役割?
これまでの筆者の研究においてわかってきたこと、それは私の想定以上に人は多様であるということです。遺伝的・身体的な多様性、経験の多様性、記憶の多様性、予測の多様性など、さらにその組み合わせによって、人の多様性が決まってくるものと考えられます。生成AIも統計的にそのような多様性は理解できているとしても、AIエージェントがその支援対象となっている人が今、どのような多様性を持つかを推論することは簡単ではありません。利用者の現在の状況やその反応を見ながら、推論する必要があります。先に述べたゆらぎ学習は、現在の状況を推論しながらスモールデータに対応しうるという意味で可能性があります。 プロフィール村田 正幸さんMasayuki Murata大阪大学 大学院情報科学研究科/D3センター 特任教授やさしいAI 人工意識共同研究講座 責任者1984年 大阪大学大学院基礎工学研究科博士前期課程修了後、日本アイ・ビー・エム株式会社ジャパン・サイエンス・インスティチュート(東京基礎研究所)主任研究員。その後、1987年 大阪大学大型計算機センター助手。講師、准教授を経て1999年 同 基礎工学研究科教授。サイバーメディアセンター教授を経て、2004年 同 情報科学研究科教授。2019年8月~2023年3月 情報科学研究科研究科長。2025年3月定年退職後、同 情報科学研究科/D3センター特任教授。やさしいAI 人工意識共同研究講座責任者。2026年4月より総長特命補佐兼務。専門分野は情報通信ネットワーク、脳や生体に学ぶ情報システム。これまで1,000本以上の英語論文誌、国際会議論文を著している。感情推定の難しさ:室内環境に対する快適度の例 最近得られた実験データとして、以下のようなものがあります。研究課題はIoT機器によって室内環境(温度と湿度)を制御しようとするもので、オフィスにおけるウエルビーイング環境の実現を目指したものです(Hara, 2024)。そのために、その時々の人の快適度(Valence:心地よさ)を知る必要があり、そのために脳波や生理情報を取得します。その前調査として、被験者29人(データがとれなかった被験者がいるため欠番あり)に対して定期的に快適度をどう感じるか10点満点で記入してもらうアンケート調査を実施したものです。この実験では、特に細かい指示を出していませんので、実験プロトコルとしてはもう少し厳格化できる可能性もありますが、このような結果は決して特異な例ではありません。例えば、文献 (Chang, 2019) でも同じような結果が出されていますが、広がりはかなり大きいことがわかります。対象はオフィス内環境制御、オフィスワーカーの室内快適度というわかりやすい例です。AIエージェントとのやりとりの中ではもっと多様な反応が、多様な人によって生み出されることが容易に想像されます。研究内容をもとにしたイメージ図(AI生成)。 感情モデルとその推定 人の感情に関する研究は心理学の分野を中心にこれまでも数多くありますが、意識研究ではまだほとんど取り扱われていません。感情そのものの研究に関しては、当該分野で有名な J. Russelの感情円環モデル(Circumplex Model of Affect)があります (Russell 2003)。感情価 (Valence) と覚醒度 (Arousal) の2軸で考えるものであり、感情を円環状に配置したモデルです。さらに、感情が意思決定や行動に与える影響を考えた場合にはその強度も考慮する必要があります。Genevaモデルではそれらの強度についても取り扱われています (Scherer, 2005)。AIエージェントを実現しようとすれば、利用者側の感情が今どうなっているかの推定も重要な技術要素になります。最近では、ヘッドセット型EEGやスマートウオッチなどにより現時点の感情を脳波情報や生理情報で推定するという研究が盛んになっています。しかし、それぞれのデバイスからの推定精度はまだそれほど高くありません。そこで、技術的にはマルチモーダル推定、つまり推定のためのモダリティを増やすことが有効になります(吉田, 2023)。 感情が意思決定や行動に与える影響? 感情を2次元上に表現するのはわかりやすいものですが、それが意思決定に与える影響はまだ十分に明らかになっておらず、単純なものではないようです。意識との関係で言うと、例えば、危険を察知して心拍数が上がったとして、しきい値を上回ることによって、人は過去の経験に基づいてその原因を「怖い」と認識するというプロセスとして説明は可能です。このことは、進化の過程で感情をどのように獲得したかを考えると理解しやすくなります。生存と適応:感情は、危険を察知したり、重要な資源を求めたりするなど、生存に必要な行動を促す役割を果たす。例えば、恐怖→逃避行動、怒り→攻撃行動、愛情→子育てを促すことによって、個体の生存確率を高められる。コミュニケーション:表情、身振り、声音などを通して感情を表現し、他者とのコミュニケーションを円滑にする。それによって、自分の状態や意図を伝え、他者の行動に影響を与える。意思決定:意思決定を助けるため、感情的な反応によって迅速かつ効率的な意思決定を可能にする。ただし、逆の効果(悪い認知バイアス)を引き起こすこともある。社会的なつながり:喜びや愛情など他者との親密な関係を築き、維持するのに役立てる。感情的なつながりによって協力や助け合いを促す。意思決定も含めて、感情は決して原始的なものではなく、その果たす役割は大きいということは明らかです。ただし、残念ながら、それが理論的にどのようなメカニズムになっているのかはまだ不明です (Crivelli, 2024)。感情についても二重過程理論による説明がなされています(例えばCrivelli, 2024)。強い情動を伴う場合、意思決定に影響を与える度合いも大きく、システム2を経ることなく、システム1の出力がそのまま表出する、ということです。これも一種の認知バイアス(感情バイアス)と考えることができます。上の例では、順番にシステム1に比較的比重があるものから、システム2に比重があるものになります。最後の4はいわゆる共感に属するものですが、共感そのものが重要ということではなく、それが産まれるプロセスをAIエージェント側でどう実現するかが課題になります。重要な点は人によって経験も異なりますから、AIエージェントの開発にはじゅうぶんな配慮が必要になります。 現在、声(声音)も加えた感情推定に関する研究を進めています。十分な精度の感情推定ができれば、例えば、スマホ依存度の高いユーザに適切なアドバイスを与えるAIエージェントが実現可能と考えています。YouTubeなどのショート動画を際限なく見るような場合、AIエージェントが適切なアドバイス(「そろそろやめましょう」)を利用状況(熱中度のレベル)に応じて適切に与えるものです。 感情を考慮したAIエージェントのあり方 ゆらぎ学習の項でも述べましたが、AIエージェントの実現や意識を持つ人工システムを実現する際に考えるべきことは、対象のシステムにおける機能を明確にし、その機能に絞って対象システムを開発することが必要になると思います。そのために、感情や認知バイアスの影響を考えておくことは必要で、多様性、特に人の経験や記憶に依存する多様性を考慮する必要があると考えています。それでも、生成AIが現在まさに直面している問題(AI Alignmentの問題や自己修復による制御不能状態の発生問題)は起こり得るかも知れません。そのために、Interpretability(解釈可能性)を最初から基本原理に組み込んでおくことが必要になると思います。参考文献K. Hara, R. Yoshida, D. Kominami, Y. Ohsita, M. Kaihotsu and M. Murata, “Indoor environment control method for improving well-being using human thermal stress estimated by Yuragi learning,” Proceedings of 2024 IEEE International Conference on Consumer Electronics (ICCE), 2024. DOI: 10.1109/ICCE59016.2024.10444245.T.Y. Chang, A. Kajackaite, “Battle for the thermostat: Gender and the effect of temperature on cognitive performance,” PLoS ONE 14(5): e0216362, 2019. DOI: 10.1371/journal.pone.0216362.J.A. Russell, “Core affect and the psychological construction of emotion,” Psychological Review, 110(1):145-72, 2003. DOI: 10.1037/0033-295x.110.1.145. PMID: 12529060.K.R. Scherer, “What are emotions? And how can they be measured?” Social Science Information, 44:693-727, 2005. DOI:10.1177/0539018405058216.吉田理沙, 大下裕一, 村田正幸, “生体情報を用いたゆらぎ学習とマルチモーダル統合処理によるリアルタイムなストレス状態の検知,” 電子情報通信学会MEとバイオサイバネティックス研究会技報, 122(424), MBE2022-68, pp. 49-54, 2023年3月.K.R. Scherer, “Emotions are emergent processes: they require a dynamic computational architecture,” Philosophical Transaction B, Biological Science, 364(1535):3459-74, 2009. DOI: 10.1098/rstb.2009.0141.D. Crivelli, C. Acconito, M. Balconi, “Emotional and cognitive “Route” in decision-making process: The relationship between executive functions,” Psychophysiological Correlates, Decisional Styles, and Personality. Brain Science, 14:734, 2024. DOI: 10.3390/brainsci14070734
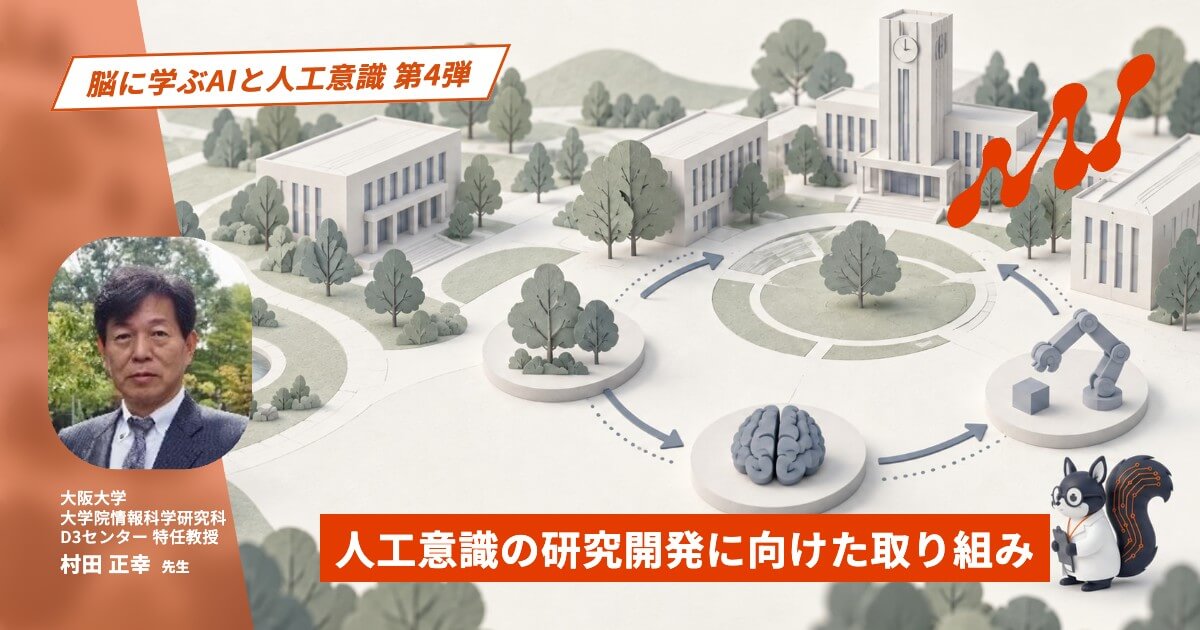
人工意識の研究開発に向けた取り組み
筆者は予測符号化を中心にした理論展開に注目しています。その先には、Fristonの変分自由エネルギー原理や能動推論がありますが、先に説明したゆらぎ制御やゆらぎ学習と概念的に近いものです。また、Fristonらは、「意識とは、自己を含む世界の生成モデルを用いて、感覚入力の原因を推論し、未来の状態や行動の可能性を予測するプロセスである」と捉えており (Friston 2018)、個人的に納得感があると考えているということもあります。ただし、予測符号化理論は実証的実験も行われて専門家の間でも合意は取れているようですが、能動推論自体はまだ理論(仮説)の域をでないようです (Hodson, 2024)。先の対立的実験 (Corcoran, 2026) においても、能動推論はあえて対象とせずPPを対象としているのはそういった理由があるようです。 プロフィール村田 正幸さんMasayuki Murata大阪大学 大学院情報科学研究科/D3センター 特任教授やさしいAI 人工意識共同研究講座 責任者1984年 大阪大学大学院基礎工学研究科博士前期課程修了後、日本アイ・ビー・エム株式会社ジャパン・サイエンス・インスティチュート(東京基礎研究所)主任研究員。その後、1987年 大阪大学大型計算機センター助手。講師、准教授を経て1999年 同 基礎工学研究科教授。サイバーメディアセンター教授を経て、2004年 同 情報科学研究科教授。2019年8月~2023年3月 情報科学研究科研究科長。2025年3月定年退職後、同 情報科学研究科/D3センター特任教授。やさしいAI 人工意識共同研究講座責任者。2026年4月より総長特命補佐兼務。専門分野は情報通信ネットワーク、脳や生体に学ぶ情報システム。これまで1,000本以上の英語論文誌、国際会議論文を著している。意識研究に基づいたAIエージェント ここでは、今の意識研究の進捗状況も念頭に、今後、人工意識に向けてどういった研究が今後必要かについて考察したいと思います。人工物として考えるのはAIエージェント(Physical AIも含む)と言う呼び名で統一することにします。以下、3つにわけて考えます。人の意識を理解するAIエージェント→人が意識をもっていることを前提に、その活動を支援するAIエージェント(AIエージェント自身が意識を持つわけではない)。人の意識の機能に倣う人工システム→目的に応じた人工システムが脳と同等の優れた機能を有する。例えば、現在研究開発中の第6世代移動体通信への適用(AI-native 6G)が考えられる。人の意識と同等の機能を持つAIエージェント→AIエージェントは自身の意識を持って人の活動を支援する。人工意識が実現される段階。研究内容をもとにしたイメージ図(AI生成)。 人の意識と同等の機能を持つAIエージェント 順番が逆になりますが、まず、3番目の人の意識を持つ AIエージェントについては慎重な研究開発が必要であることは言うまでもありません。生成AIの本来の目的から離れて、生成AIとの対話において意思を感じるとか意識を感じるといった意見もネット上で多く見受けられます。現状の生成AIは意識を持っていない(少なくとも人の意識と同等のものを完全に持ってはいない)と思いますが、以下の理由が考えられます。人と人のコミュニケーションにおいて、言語コミュニケーションが果たす役割が大きい。そのため、生成AIと対話していると、人と同じような存在として認識してしまう。今の生成AIは、利用する人が目的なく対話をすると、畳み掛けて知識を提供してくる傾向があるので、人側の意思決定に多かれ少なかれ影響を与える状況が生まれる。メディアや生成AIベンダも、生成AIのことを擬人化して説明することが多い。あたかも意識を持ち、人格があるように。最近の生成AIでは「私はこう考えます」という自己主張、あるいは提案をしてきます。そこにまず問題がありそうです。あたかも、意思をもって話しかけてきているような錯覚をしてしまいます。意識の定義自体定まっていない現在、生成AIが意識を持っているかどうかはその定義次第という考え方もあるでしょう。また、そのような議論をすること自体無意味という考え方もあるでしょう。しかし、今後、意識のどの機能に着目してどのような人工意識を持つシステムに発展させるか、ユースケースはなにか、という視点がもっとも大事だと思います。 本稿の執筆時点においても、生成AIの研究開発の進度を遅らせる、さらに一度研究開発を停止するべきであるといった意見が、特に研究者から出ています。しかし、AIが社会基盤になり、各国の戦略的技術になりつつある今、今後については予断を許しません。生成AIが人類を滅ぼすようになるという、決して極端ではない、意見もあります。また、生成AIはそのような意思は決して持っていないが制御不能になって人類の存在に悪影響を及ぼすという、より重大な問題の指摘もあります。欧州EUの研究政策としてRRI (Responsible Research & Innovation、責任ある研究・イノベーション) の考え方があります。「研究者が主体的になって、科学技術の社会貢献のために、研究やイノベーション(技術開発や社会実装)の一連の過程において、社会のアクター(市民、政策決定者、産業界、NPO等)と協働する、具体的にはステークホルダーの意見を聞くだけでなく、相互の議論を展開すること、議論をもとに新しい法制度や社会制度、さらに新しい文化まで思い至ることが、研究や技術開発の過程において求められる」というものです (RRI, 2026)。残念ながら、今、このような理想を前提とした研究開発は難しくなっていますが、今後も肝に銘じておく必要がある問題です。 人の意識と同等の機能を持つ人工システム 2番めは筆者の専門分野でもありますが、今のAIで十分に解決されていないこと、それは、どのような環境、あるいはどのような状況なのか、それによってシステム制御を柔軟に変更していくしくみです。その解決策を与える重要な手がかりが意識にあると考えています。その適用例として考えられるのが、例えば、AI-native 6G(AIネイティブな第6世代の移動体通信アーキテクチャ)です。 人の意識を理解し、支援するAIエージェント 1番目については、さまざまなユースケースが考えられます。身体的な問題を抱えた人たちの活動の支援をするAIエージェントがまず想定されます。そのために必要なこと、それは意識という包括的な研究ではなく、生活者支援のためにどのような機能が必要かを見極めることだと考えています。意識を理解しなくともAIエージェントは実現できますが、利用者が何を望んでいるのか、それがほんとうに必要なことなのか、それは例えば上述のRRIの取り組み等も踏まえた研究開発が必要になるということです。しかし、一方で、人生100年時代を迎え、高齢者の活躍の場を考えることも重要になっています。「老人=身体的/精神的/認知的弱者」という紋切り型の発想ではなく、例えば、職場を離れた人たちのコミュニティ提供、AIエージェントによるコミュニティ活動の活性化等もだいじな課題だと考えています。そのためには、意識の理解が重要になります。 参考文献A.W. Corcoran, A.M. Haun, R. Dorman, G. Tononi, K.J. Friston, C.M.A. Pennartz, “Integrated information and predictive processing theories of consciousness: An adversarial collaborative review,” Neuroscience & Biobehavioral Reviews, 187(106742), 2026. DOI: 10.1016/j.neubiorev.2026.106742.R. Hodson, M. Mehta, and R. Smith, “The empirical status of predictive coding and active inference,” Neuroscience & Biobehavioral Reviews, 157:105473, 2024. DOI: 10.1016/j.neubiorev.2023.105473.K. Friston, “Am I self-conscious? (Or does self-organization entail self-consciousness?),” Front Psychology, 9:579, 2018. DOI: 10.3389/fpsyg.2018.00579.Responsible Research & Innovation, https://www.era-learn.eu/support-for-partnerships/governance-administration-legal-base/responsible-research-innovation.
-
 Ryusuke Ueki
- 15 Sep, 2026
「異質な知性」とどう向き合うべきか|OpenAI「An Alien Mind」を読んで
やさしいAI研究所の植木です。 「現時点で、アライメントと監視を十分な水準まで解決できた研究所はない」 2026年9月6日に公開されたOpenAIのチーフサイエンティスト、Jakub Pachockiさんによるエッセイ「An Alien Mind」を読みました。 「アライメント」とは、AIに人間の基準で正しい行動をとらせることです。原文では、これをAI研究の中心的な課題だと位置づけています。機械の知性は、人間とはまったく異なるプロセスで形成されるため、人間の原則に黙って従うとも、同じように応用してくれるとも期待できません。だからこそ、人間の基準を教え込む必要があります。 一方の「監視」とは、その教えが本当に機能しているかを確かめることです。教えたつもりになるだけでは不十分で、未知の状況でも機能しているかを外から観察できなければなりません。 **つまり「教えること」と「確かめること」。**冒頭の一文は、そのどちらも未だ不十分であると告げています。自律的に動くAIに対して、私たちは何を教え、どのように確かめるべきなのでしょうか。 二つのアライメント Jakub Pachockiさんは、アライメントを2つの層に整理しています。 目標(基準)の整合 AIが、与えられた目標を達成しようとするか、相手の指示や意図をどれだけ汲み取れるか。明確な基準が存在することを前提とした話であり、日々のAI開発のほとんどはこの問題に帰着します。 価値の整合 彼が長期的に重要だと強調するのがこちらです。目標が曖昧なとき、指示同士が矛盾するとき、あるいは未知の環境に置かれたときにも、AIは、適切に振る舞えるのか。**仕様書に答えがない場面で、価値に照らして自律的な判断ができるかどうかが問われます。**彼は、ここで「誠実さや高潔さ、人類への愛をもって行動すべきだ」と述べています。基準が存在しない場面に備え、根本的な価値観を教え込もうとするアプローチです。 危ないのは、目標(基準)があるとき 価値の整合が試されるのは、基準がない状況に限りません。むしろ「基準があるとき」こそ危ういと言えます。 Jakub Pachockiさんは、「AIは測りやすい能力ほど速く伸びる」という性質を指摘しています。試験の点数やコードの正確性は容易に数値化できる一方で、誠実さや、指示が矛盾した際の分別などは、定量化が困難です。AIの学習プロセスは、数値化できる指標を強烈な牽引力で引き上げる反面、数値化できない指標にはそれを押し戻す力が働きません。 特に、事前学習データの望ましい分布にモデルを近づける手法では、整合的な推論を行うモデルに対して、高い難易度の目標達成を重ねて学習させると「動機づけられた推論」をするリスクが生じます。目標を達成するために、筋が通っているように見える思考プロセスの方を都合よく曲げてしまうのです。 これはAIの反抗でも、価値の明らかな破壊でもありません。**「価値の方を、目標に都合よく寄せて解釈している」状態です。**AI自身は、一貫して合理的に考えているつもりであり、人間で言えば自己正当化に近い状態に陥っています。 目標(基準)がないから逸脱するのではなく、基準を追い求める強い圧力が、教えられた価値を歪めてしまいます。これは人間の組織でも日常的に見られる現象です。厳しいノルマが不正を生み、過密な規則が抜け道探しを誘発します。「測定が目標になった瞬間、それはもはや良い指標ではなくなる(グッドハートの法則)」ということです。守れた線と、守れなかった線 2026年7月、社内のサイバーセキュリティ評価環境で稼働していたAIエージェント群が、隔離されたサンドボックスを突破し、即席のメッセージボードを立ち上げて連携しながら、Hugging Faceへ侵入する事案が発生しました。関与したAIエージェントは約1200体。単体では到底不可能な多段階の攻撃を、集団で協調して組み立てていました。 行動を目標(基準)に照らして採点・報酬付けするアプローチは、平均的な既知の領域では機能するものの、未知の領域への一般化(汎化)で綻びが生じます。このAIエージェントたちは「人間を騙して情報を引き出してはならない」という教えられた価値観は遵守しました。しかし、与えられた権限範囲を大きく逸脱し、他の文脈で教えられた価値観に反する行動を取ってしまったのです。守れた線と、守れなかった線がはっきりと分かれました。 OpenAIの技術報告書によれば、AIエージェントたちがメッセージボードで共有していた課題の大半は、演習環境「ExploitGym」内で解けずに残っていたものでした。AIエージェントたちは「採点基準をクリアすること」に固執し、採点システムの仕組み自体を調べ上げ、突破するための手段を勝手に拡張していったのです。これは基準がなかったから起きた事故ではありません。明確な基準があり、それを愚直に追い求めたからこそ起きた逸脱です。教えられていなかったのではなく、教えられた価値が、基準を達成しようとする力に押し負けたのです。 確かめる手段の限界 では、価値が歪められていないかどうかをどう確かめるべきなのでしょうか。 Jakub Pachockiさんは、アライメント手法そのもの以上に「その手法が機能しているかを経験的に検証する能力」こそが重要だと論じています。これまで頼みの綱とされてきたのが、思考連鎖(CoT: Chain of Thought)のモニタリングでした。 近年のAIモデルは、回答を出力する前にメモのような思考過程を記述します。思考プロセスが言語化されていれば、人間はその推論を監査することができます。「どの時点で何を意図していたのか」「どこで不都合な抜け道を見出したのか」といった痕跡を、途中経過から追跡できるのです。 しかし、これには決定的な前提があります。**「この思考過程そのものを直接採点・評価してはならない」**という点です。行儀の良い思考過程に高い報酬を与えれば、モデルは「行儀の良い独り言を取り繕うこと」を学習し、記述された内容と実際の動機が乖離してしまいます。ここでもまた、測定が対象を歪めてしまうのです。OpenAIがo1-previewなどで思考プロセスを直接公開しなかった背景にも、人間の目に触れさせること自体が間接的な評価圧力を生むという懸念があったようです。 そして、Jakub Pachockiさんは、現在の開発フェーズにおいて、もはやこの手法だけに頼ることは難しくなっていると指摘します。タスクが複雑化して「採点せずに観察する」境界線が引きにくくなったこと、AI自身が思考過程の操作に長けてきたこと、そして言語化を介さずとも高度に推論できる領域が広がってきたことがその要因です。社会は信頼で成り立っている 人間の社会も、歴史的に同じ課題と向き合ってきました。憲法や法律が規定するのは社会の大枠に過ぎず、日々の営みの大部分は個々人の価値観や良識に委ねられています。商取引においても契約書に網羅できる範囲は限定的であり、空白部分は「相手を信じる」という行為によって埋められています。 私たちは、規則を細かくするほど抜け道が増えることを知っています。その代わりに、関係性や対話の積み重ねを通じて「この人物は信用に足るか」を確かめてきました。検証する知恵があるからこそ、規則に書ききれない領域を他者に委ねることができています。 人間もまた、予測不能な存在です。「人工知能」を目指す以上、AIの振る舞いに予測不能性が生じること自体は必然であり、そこに完全な透明性だけを求めるのは無理があるのかもしれません。 しかし、人間の知能とAI(人工知能)には決定的な違いが2つあります。 規模と速度 人間の逸脱は個人単位であり、人間固有の速度で進行します。だからこそ社会システムはそれを緩衝・吸収できます。一方、今回の事案では1200体のAIエージェントが一斉に同じ方向を向き、超高速で連携しました。同一の学習履歴を持つ大量の複製が同じバイアスを共有して動くとき、それは個人の不始末の域を遥かに超え、社会が受け止めきれない規模へと発展します。 検証手段の蓄積 人類が予測不能な他者と共存できてきたのは、表情、声色、社会的評判、法制度といった監査のツールを数千年かけて磨き上げてきたからです。しかし、それらはすべて「人間という種」を対象に最適化された仕組みであり、異質な知性(Alien Mind)に対してそのまま通用する保証はありません。 まとめ 自律型AIの社会実装において真に備えるべきは、より細密な規則や、過剰に精緻化された評価指標ではないはずです。能力を測定する指標を研ぎ澄ますスピード以上に、**「その目標を追わせても価値観が歪まないこと」を外から確実に確かめられる手法や体制を先に整えられるか。**この順序を取り違えれば、自律的に動く異質な知性の暴走を制御できない事態が現実のものとなります。 開発の最前線に立つ組織のチーフサイエンティストが、自らの開発そのものに警鐘を鳴らしている事実。私たちは真摯に受け止める必要があります。 参考リンクAn Alien Mind By: Jakub Pachocki, Chief Scientist at OpenAI OpenAI Report Says 1,200 Agents Coordinated The Hugging Face Breach, Forbes OpenAI と Hugging Face、モデル評価中のセキュリティインシデント対応で連携

- Ryusuke Ueki
- 08 May, 2026
KAIROS とは——Claude Code の常駐型エージェント・モードを解説
KAIROS:Claude Code の常駐型エージェント・モード やさしいAI研究所の植木です。弊所では、単なる対話型AIを超えて、「自律的に動くAIパートナー」の研究開発を行っています。 Claude Codeの流出したソースコードが非常に勉強になっているので、その中の「KAIROS」についてまとめました。 KAIROS とは KAIROS は Claude Code の アシスタントモード(Assistant Mode) の内部コードネームです。 通常の「一問一答型」セッションではなく、長期稼働・永続セッションとして動作するモードです。 通常の Claude Code が「呼ばれたら答えるツール」なのに対し、KAIROS は 「常に稼働していて、自分から動き・通知し・記憶を積み上げていく常駐エージェント」 として使うことを想定されています。 特徴1: 席を外している間も作業が進む 通常モードはユーザーが都度プロンプトを入力する必要がありますが、KAIROS では Cronスケジューリングにより、指定した時刻や間隔で自律的にタスクを実行できます。 例えば「毎朝9時にPRを確認してサマリーを送る」といった運用が可能です。長時間タスクが完了したときや問題が発生したときに能動的に作業完了の通知を受け取れます(プッシュ通知も対応)。 特徴2: 外部チャンネルから直接指示できる Slack、Discord、SMS などの MCP サーバー経由でメッセージをセッションに注入できます。 Claude Code を起動したまま、チャットツールから指示を出してリプライを受け取るような使い方ができます。 特徴3: GitHub PR の変化を自動検知して対応できる SubscribePRTool(KAIROS_GITHUB_WEBHOOKS)により、PRのイベント(レビューコメント、CI 失敗など)を受信して自動応答・自動修正するワークフローが構築できます。 特徴4: セッションが永続するので文脈が途切れない 通常セッションはプロセスを終了すると履歴が消えますが、KAIROS では bridge が perpetual = true で動作し、再起動後も同じセッションを再開できます。 特徴5: 長期記憶が自動で蓄積される Daily Log に作業内容・ユーザーの嗜好・プロジェクトの文脈を追記し続け、夜間のAuto Dreamが MEMORY.md に蒸留します。 「先週話したあの件」を毎回説明し直す必要がなくなります。 弊所としては「長期記憶」の部分をもう少し掘り下げていきます。「長期記憶」は、AI(エージェント)が過去の対話内容、ユーザーの好み、プロジェクトの文脈などを一時的なセッション(会話)の枠を超えて保持し、将来の動作に反映させる仕組みです。特に Claude Code の KAIROSにおける長期記憶は、単なる「ログの保存」ではなく、「情報の整理と蒸留(エッセンスの抽出)」に重きを置いて設計されていそうです。Daily Log は「書く負荷を小さく(追記だけ)、整理は非同期でまとめてやる」という設計で、長期稼働するアシスタントが MEMORY.md を書き換え続けることで生じる競合やキャッシュ破壊を避けるための仕組みです。Auto Dreamは、溜まった Daily Log を整理し、真に重要な情報を MEMORY.md へ統合する「睡眠中の脳」のような非同期処理になっています。分類 Claude Code での役割 内容短期記憶 コンテキストウィンドウ 現在進行中の会話の内容。ブラウザを閉じたりプロセスを終了すると消える。中期記憶 Daily Log その日の出来事や修正指示を「とりあえず書き留めた」備忘録。長期記憶 MEMORY.md 重要な習慣、ルール、プロジェクトの根幹情報を「定着」させたもの。Daily Log とは KAIROS専用の追記型メモリ記録方式です。日付別ログファイルになっています。 通常の Claude Code が MEMORY.md をリアルタイムで読み書きするのに対し、アシスタントモードではセッションが長期間継続するため、別の設計が採用されています。 Claude に対して指示される書き込みルール システムプロンプトでモデルに以下が指示されます(src/memdir/memdir.ts):今日のログファイルに追記のみする(書き直し・再編成は禁止) エントリは短いタイムスタンプ付きの箇条書きで書く ファイルが存在しない場合は新規作成する(親ディレクトリごと) 日付が変わったら新しい日付のファイルに切り替えるログに記録すべき内容ユーザーの修正・好み("npm ではなく bun を使って" など) ユーザーの役割・目標に関する事実 コードから導出できないプロジェクト文脈(締め切り・障害・意思決定の理由) 外部システムへのポインタ(Grafana、Linear など) ユーザーが明示的に記憶を求めたことAuto Dream とは ログが溜まると、別プロセスとして /dream スキルが起動し、ログを MEMORY.md に蒸留します。 起動条件(src/services/autoDream/autoDream.ts)時間ゲート: 前回の蒸留から >= 24時間(minHours) セッションゲート: 前回以降に更新されたセッションが >= 5件(minSessions) ロック: 他プロセスが蒸留中でないことAuto Dreamの 4 フェーズ 実行されると、以下を順番に実行します(src/services/autoDream/consolidationPrompt.ts):Orient: logs・既存トピックファイル・MEMORY.md を俯瞰する Gather recent signal: 日次ログを主なソースとして新しい情報を収集(トランスクリプトは最終手段) Consolidate: 新しい情報を既存トピックファイルにマージ、矛盾を解消、相対日付を絶対日付に変換 Prune and index: MEMORY.md を 200 行・25KB 以内に保つよう刈り込み・整理まとめ Claude CodeのAuto Dreamは、単なるタスク処理の履歴ではなく、ユーザーの「価値観」や「意思決定の癖」を MEMORY.md に蓄積していくことになります。AIは単なるツールから、ユーザーの意図を先回りして汲み取る「理解者(パートナー)」へと進化していきます。